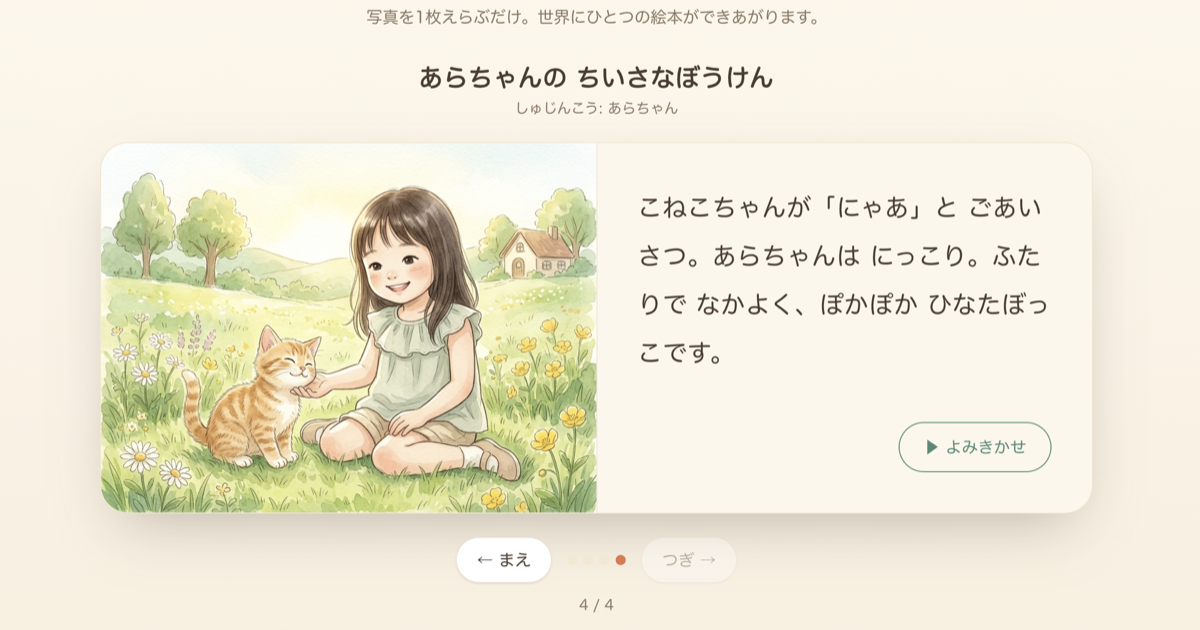
写真 1 枚から絵本ができる ── Gemini API でマルチモーダルなアプリを作るコース公開
 高塚 智明(メンター)
生成 AI の API というと、文章を投げて文章が返ってくるチャットの形を思い浮かべる方が多いかもしれません。しかし実際の API には、写真を読む・決めた形の JSON で返す・画像を作る・音声を作るといった機能が揃っていて、しかもそのすべてを同じ呼び方のまま、モデル名を変えるだけで扱えます。
今回のコラムでは、新たに公開された「Gemini API で AI 絵本メーカーを作る」コースを取り上げ、写真 1 枚から挿絵と読み聞かせ付きの絵本ができあがる Web アプリを、どのように組み上げていくかを整理します。
どんな人にフィットするコースか
- 生成 AI の API をはじめて自分の手で叩く方: キーの取得から 1 回目の呼び出しまでを、つまずきやすいところを含めて丁寧に進みます
- チャット以外の使い道を知りたい方: 画像を読む・画像を作る・声を作るという 3 つの入出力を、1 つのアプリの中でまとめて扱います
- 作ったものが目に見える題材で学びたい方: 毎回のレクチャーで画面が変わり、最後は手元の写真で絵本が 1 冊できあがります
- Next.js は詳しくないが、生成 AI の API を試したい方: 画面側のコードはすべて本文に載せているので、API を呼ぶ部分に集中して進められます
前提は TypeScript を読み書きできることです。画面は Next.js と React で作るので、どちらかに触れたことがあると読み進めやすくなります。Gemini API の使い方だけを知りたい場合は、レクチャーごとに完成コードの zip を用意しているので、そこから手元で動かして、画面の実装を追わずに API の動作だけを確かめることもできます。
コースで得られる実践知識
- マルチモーダル入力の扱い方: 写真を base64 にして文章と一緒に渡し、写っているものを説明させます。ブラウザ側で画像を縮めてから送る理由も扱います
- 構造化出力(
response_format): 返事を決めた形の JSON で受け取ります。各キーの description がそのまま指示として効くこと、required に書いたキーが欠けずに返ることを、絵本の設計図づくりを通して押さえます - 複数の画像で同じキャラクターを保つ方法: 参照写真・見た目の描写・絵柄の指定の 3 つを毎回渡す設計に行き着くまでを、失敗例と並べて扱います
- 音声生成と PCM の扱い: 返ってくる生データに 44 バイトのヘッダーを付けて WAV にし、ブラウザで再生できる形に変えます
- 待たせない組み立て方: 全部そろう前に見せる、あとで使うものを裏で先に作っておく、という 2 つの考え方を実装に落とします
- API キーと費用の扱い: キーを漏らさないための置き場所、課金の仕組みと月あたりの上限の決め方、使い終わったあとの削除まで扱います
コースの中身をチラ見せ
挿絵を描かせる関数です。1 ページごとにこの関数を呼び、4 ページなら 4 枚を順に描かせます。
const interaction = await ai.interactions.create({
  model: IMAGE_MODEL,
  input: [
    {
      type: "text",
      text: [
        `A single illustration for a children's picture book. Style: ${input.artStyle}`,
        `Main character: ${input.appearance}`,
        `Scene to draw: ${input.scene}`,
        "Use the reference photo ONLY for the character's face, hair and clothing, redrawn in the illustration style.",
        "Ignore everything else in the reference photo: its background, its location, and any object the character is holding.",
        "Do not render any text, letters or numbers in the image.",
      ].join("\n"),
    },
    { type: "image", data: input.photo, mime_type: "image/jpeg" },
  ],
  response_format: {
    type: "image",
    mime_type: "image/jpeg",
    aspect_ratio: "4:3",
    image_size: "1K",
  },
});
ポイントは、1 冊の中で変わってはいけないものを先に決めて、毎ページ同じものを渡しているところです。artStyle は絵柄、appearance は主人公の見た目で、どちらも物語を作るときに一度だけ決めて、あとは使い回します。ページごとに変わるのは scene だけです。
参照写真だけを渡すと絵柄が毎回揺れ、言葉だけで説明すると写真から離れていきます。両方を渡したうえで、写真の背景や持ち物まで描き込まれないよう範囲を絞る。この 3 つが揃ってはじめて、全ページで同じ子に見えるようになります。コースでは、この結論にたどり着くまでの過程を順番に扱います。
待ち時間をどう扱うか
絵本 1 冊の生成には、1 分前後かかります。文章を作るのに 10 秒ほど、挿絵は 1 枚あたり 15 秒ほど、読み聞かせの音声も 1 ページあたり 10 秒ほどです。
このコースでは、待ち時間そのものを短くするのではなく、いつ見せるかを変えます。全部そろうのを待たずに物語ができた時点で絵本を開き、絵はあとから 1 枚ずつ埋めます。読み聞かせの音声は、絵を描いている裏で先に作っておきます。処理の総量は変わりませんが、何も映らない時間と、ボタンを押してからの待ち時間が無くなります。
生成に時間のかかる機能を扱うアプリでは、この考え方がそのまま使えます。
サブスク加入で広がる学習体験
メンバーシップでは、本コースをはじめとしたオンデマンド講座を横断的に学べるだけでなく、
- スキル領域別の学習パスで次に学ぶテーマを迷わず選定
- AI チャットによるサポート
- Discord での質問対応や必要に応じたビデオサポート、月イチのオンラインセッションで疑問をリアルタイムに解消(サポートプラン・共同開発プラン)
- 毎週のアジャイル運用で実務のコツを無理なく習得(共同開発プラン)
継続的にアップデートされるコンテンツラインアップを活用すれば、個人もチームも中長期の学習プランを描きやすくなります。詳細は メンバーシップページ でご確認いただけます。
編集部より
生成 AI の API は、ドキュメントを読んだだけでは「何に使えるのか」が掴みにくい領域です。このコースでは、写真 1 枚を入れると絵本が出てくるという分かりやすい出口を置いたうえで、画像理解・構造化出力・画像生成・音声生成を通しで扱います。手元の写真で 1 冊作り終えたときには、次に自分が作りたいものの設計図も描けるようになっているはずです。